-
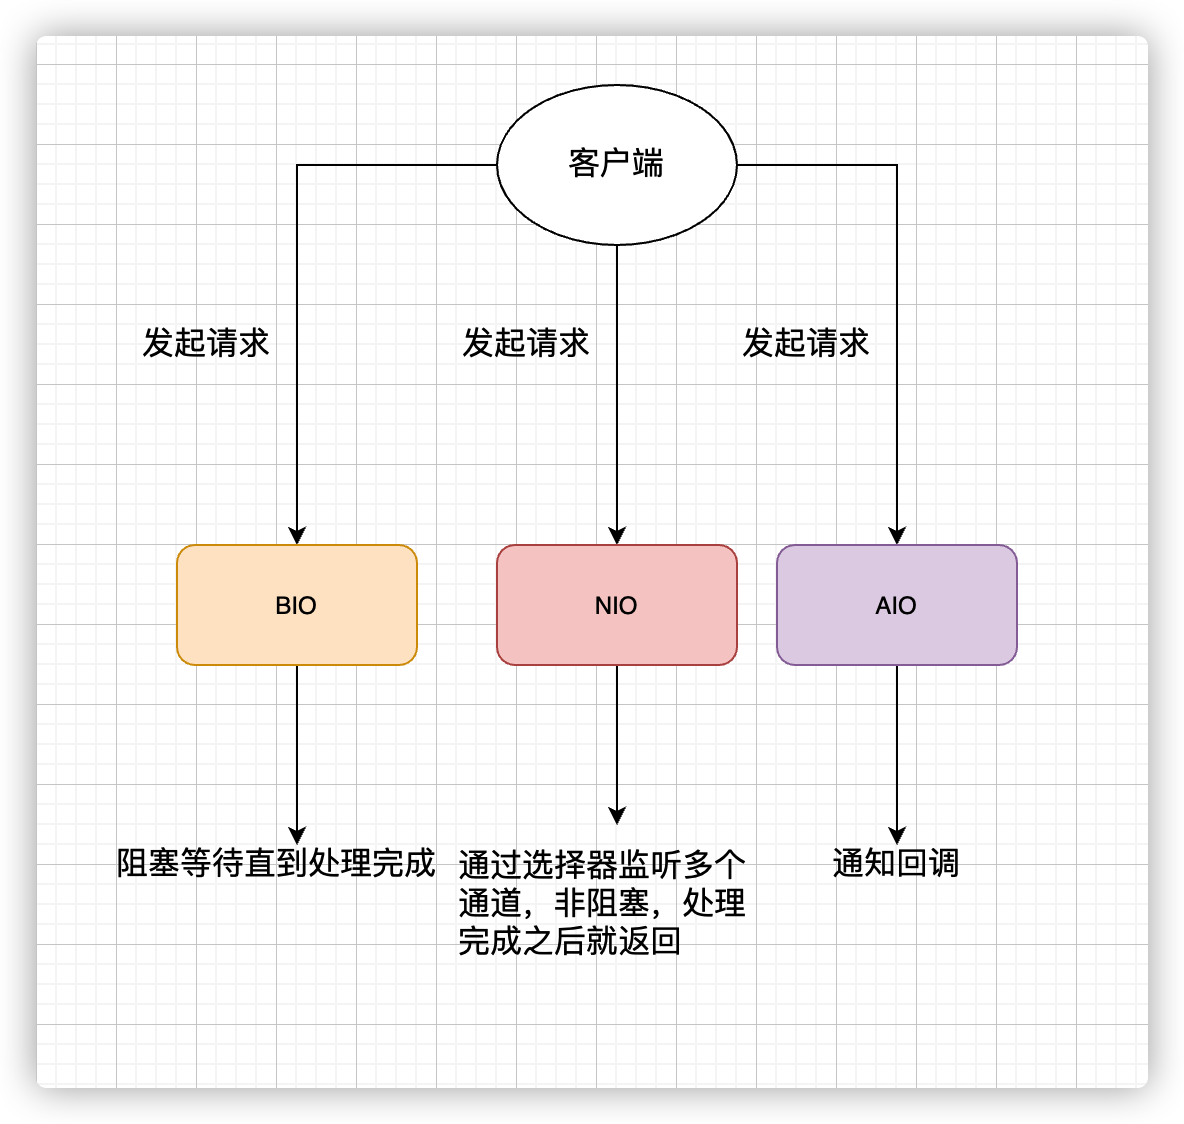
IO的方式通常分为几种,同步阻塞的BIO、同步非阻塞的NIO、异步非阻塞的AIO。
-
BIO全称是Blocking IO,是JDK1.4之前的传统IO模型,本身是同步阻塞模式。 线程发起IO请求后,一直阻塞IO,直到缓冲区数据就绪后,再进入下一步操作。
-
NIO也叫Non-Blocking IO 是同步非阻塞的IO模型。线程发起io请求后,立即返回(非阻塞io)。同步指的是必须等待IO缓冲区内的数据就绪,而非阻塞指的是,用户线程不原地等待IO缓冲区,可以先做一些其他操作,但是要定时轮询检查IO缓冲区数据是否就绪。IO多路复用模型中,将检查IO数据是否就绪的任务,交给系统级别的select或epoll模型,由系统进行监控,减轻用户线程负担。
-
BIO只能接收一个连接,无法处理大量连接。NIO单线程处理多个连接。
-
BIO方式适用于连接数目比较少且固定的架构,这种方式对服务器资源要求比较高,并发局限于应用中,JDK1.4以前的唯一选择,程序只管简单易理解。
-
NIO方式适用于连接数目多且比较短的架构,比如聊天服务器,并发局限于应用中,编程比较复杂,JDK1.4开始支持。
网络IO往往是性能瓶颈,CPU和磁盘或许仍然会比网络速度快几个数量级。在这种情况下,你绝对不希望让异常快速的CPU等待相对缓慢的网络。 参考博客
epoll是linux环境下的一种IO多路复用机制。(共有3种实现方式:select,poll,epoll)
IO多路复用是一种同步IO模型,实现一个线程可以监视多个文件句柄;一旦某个文件句柄就绪,就能够通知应用程序进行相应的读写操作;没有文件句柄就绪时会阻塞应用程序,交出cpu。多路是指网络连接,复用指的是同一个线程。
epoll可以监视的文件描述符数量突破了1024的限制(十万),同时不需要通过轮询遍历的方式去检查文件描述符上是否有事件发生,因为epoll_wait返回的就是有事件发生的文件描述符。本质上是事件驱动。
具体是通过红黑树和就绪链表实现的,红黑树存储所有的文件描述符,就绪链表存储有事件发生的文件描述符;
- epoll_ctl可以对文件描述符结点进行增、删、改、查,并且告知内核注册回调函数(事件)。
- 一旦文件描述符上有事件发生时,那么内核将该文件描述符节点插入到就绪链表里面
- 这时候epoll_wait将会接收到消息,并且将数据拷贝到用户空间。
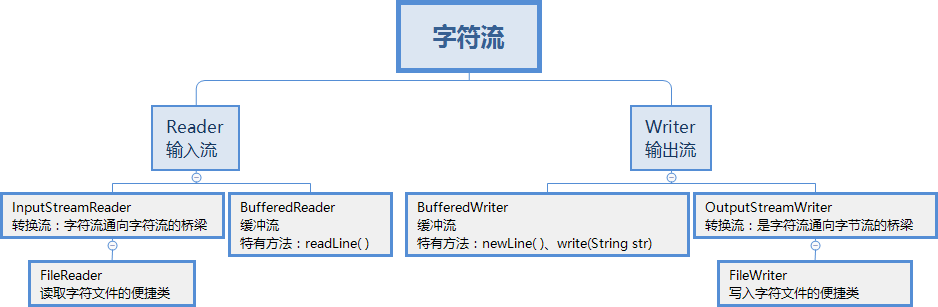
按照流的方向:输入流(inputStream)和输出流(outputStream)
按照实现功能分:节点流(可以从或向一个特定的地方(节点)读写数据。如 FileReader)和处理流(是对一个已存在的流的连接和封装,通过所封装的流的功能调用实现数据读写。如 BufferedReader。处理流的构造方法总是要带一个其他的流对象做参数。一个流对象经过其他流的多次包装,称为流的链接。)
按照处理数据的单位: 字节流和字符流。字节流继承于 InputStream 和 OutputStream, 字符流继承于InputStreamReader 和 OutputStreamWriter 。
UNIX 系统下, IO 模型一共有 5 种: 同步阻塞 I/O、同步非阻塞 I/O、I/O 多路复用、信号驱动 I/O 和异步 I/O。Java 中 3 种
(1) BIO (Blocking I/O) 同步阻塞 IO 模型
同步阻塞 IO 模型中,应用程序发起 read 调用后,会一直阻塞,直到在内核把数据拷贝到用户空间。
在客户端连接数量不高的情况下,是没问题的。但是,当面对十万甚至百万级连接的时候,传统的 BIO 模型是无能为力的。因此,我们需要一种更高效的 I/O 处理模型来应对更高的并发量。
(2) NIO (Non-blocking/New I/O) 同步非阻塞 IO 模型
Java 中的 NIO 于 Java 1.4 中引入,对应 java.nio 包,提供了 Channel , Selector,Buffer 等抽象。NIO 中的 N 可以理解为 Non-blocking,不单纯是 New。它支持面向缓冲的,基于通道的 I/O 操作方法。 对于高负载、高并发的(网络)应用,应使用 NIO 。
Java 中的 NIO 可以看作是 I/O 多路复用模型。也有很多人认为,Java 中的 NIO 属于同步非阻塞 IO 模型。
同步非阻塞 IO 模型中,应用程序会一直发起 read 调用,等待数据从内核空间拷贝到用户空间的这段时间里,线程依然是阻塞的,直到在内核把数据拷贝到用户空间。
相比于同步阻塞 IO 模型,同步非阻塞 IO 模型确实有了很大改进。通过轮询操作,避免了一直阻塞。
但是,这种 IO 模型同样存在问题:应用程序不断进行 I/O 系统调用轮询数据是否已经准备好的过程是十分消耗 CPU 资源的。
这个时候,I/O 多路复用模型就上场了。 IO 多路复用模型中,线程首先发起 select 调用,询问内核数据是否准备就绪,等内核把数据准备好了,用户线程再发起 read 调用。read 调用的过程(数据从内核空间->用户空间)还是阻塞的。
目前支持 IO 多路复用的系统调用,有 select,epoll 等等。select 系统调用,是目前几乎在所有的操作系统上都有支持
select 调用 :内核提供的系统调用,它支持一次查询多个系统调用的可用状态。几乎所有的操作系统都支持。 epoll 调用 :linux 2.6 内核,属于 select 调用的增强版本,优化了 IO 的执行效率。 IO 多路复用模型,通过减少无效的系统调用,减少了对 CPU 资源的消耗。
Java 中的 NIO ,有一个非常重要的选择器 ( Selector ) 的概念,也可以被称为 多路复用器。通过它,只需要一个线程便可以管理多个客户端连接。当客户端数据到了之后,才会为其服务。
(3) AIO (Asynchronous I/O)
AIO 也就是 NIO 2。Java 7 中引入了 NIO 的改进版 NIO 2,它是异步 IO 模型。
异步 IO 是基于事件和回调机制实现的,也就是应用操作之后会直接返回,不会堵塞在那里,当后台处理完成,操作系统会通知相应的线程进行后续的操作。
目前来说 AIO 的应用还不是很广泛。Netty 之前也尝试使用过 AIO,不过又放弃了。这是因为,Netty 使用了 AIO 之后,在 Linux 系统上的性能并没有多少提升。
最后,来一张图,简单总结一下 Java 中的 BIO、NIO、AIO。
字节输入流转字符输入流通过 InputStreamReader 实现,该类的构造函数可以传入 InputStream 对象。
字节输出流转字符输出流通过 OutputStreamWriter 实现,该类的构造函数可以传入 OutputStream 对象。
在 java 中能够被序列化的类必须先实现 Serializable 接口,该接口没有任何抽象方法只是起到一个标记作用。
public class Test {
    public static void main(String[] args) throws Exception {
        //对象输出流
        ObjectOutputStream objectOutputStream =
                new ObjectOutputStream(new FileOutputStream(new File("D://obj")));
        objectOutputStream.writeObject(new User("zhangsan", 100));
        objectOutputStream.close();
        //对象输入流
        ObjectInputStream objectInputStream = new ObjectInputStream(new FileInputStream(new File("D://obj")));
        User user = (User) objectInputStream.readObject();
        System.out.println(user);
        objectInputStream.close();
    }
}字节流读取的时候,读到一个字节就返回一个字节;字符流使用了字节流读到一个或多个字节(中文对应的字节数是两个,在 UTF-8 码表中是 3 个字节)时。先去查指定的编码表,将查到的字符返回。字节流可以处理所有类型数据,如:图片,MP3,AVI视频文件,而字符流只能处理字符数据。只要是处理纯文本数据,就要优先考虑使用字符流,除此之外都用字节流。字节流主要是操作 byte 类型数据,以 byte 数组为准,主要操作类就是 OutputStream、InputStream字符流处理的单元为 2 个字节的 Unicode 字符,分别操作字符、字符数组或字符串,而字节流处理单元为 1 个字节,操作字节和字节数组。所以字符流是由 Java 虚拟机将字节转化为 2 个字节的 Unicode 字符为单位的字符而成的,所以它对多国语言支持性比较好!如果是音频文件、图片、歌曲,就用字节流好点,如果是关系到中文(文本)的,用字符流好点。在程序中一个字符等于两个字节,java 提供了 Reader、Writer 两个专门操作字符流的类。
6、如何实现对象克隆?
有两种方式:
● 实现 Cloneable 接口并重写 Object 类中的 clone()方法;
● 实现 Serializable 接口,通过对象的序列化和反序列化实现克隆,可以实现真正的深度克隆,代码如下:
class MyUtil {
    private MyUtil() {
        throw new AssertionError();
    }
    public static <T extends Serializable> T clone(T obj) throws Exception {
        ByteArrayOutputStream bout = new ByteArrayOutputStream();
        ObjectOutputStream oos = new ObjectOutputStream(bout);
        oos.writeObject(obj);
        ByteArrayInputStream bin = new ByteArrayInputStream(bout.toByteArray());
        ObjectInputStream ois = new ObjectInputStream(bin);
        return (T) ois.readObject();
        // 说明:调用 ByteArrayInputStream 或 ByteArrayOutputStream 对象的 close 方法没有任何意义
        // 这两个基于内存的流只要垃圾回收器清理对象就能够释放资源,这不同于对外部资源(如文件流)的释放
    }
}
测试代码:
import java.io.Serializable;

/**
* 人类
*/
class Person implements Serializable {
   private static final long serialVersionUID = -91020170202878978L;
   private String name; // 姓名
   private int age; // 年龄
   private Car car; // 座驾

   public Person(String name, int age, Car car) {
       this.name = name;
       this.age = age;
       this.car = car;
   }

   public String getName() {
       return name;
   }

   public void setName(String name) {
       this.name = name;
   }

   public int getAge() {
       return age;
   }

   public void setAge(int age) {
       this.age = age;
   }

   public Car getCar() {
       return car;
   }

   public void setCar(Car car) {
       this.car = car;
   }

   @Override
   public String toString() {
       return "Person [name=" + name + ", age=" + age + ", car=" + car + "]";
   }
}- 小汽车类
class Car implements Serializable {
    private static final long serialVersionUID = -57138907627603702L;
    private String brand; // 品牌
    private int maxSpeed; // 最高时速

    public Car(String brand, int maxSpeed) {
        this.brand = brand;
        this.maxSpeed = maxSpeed;
    }

    public String getBrand() {
        return brand;
    }

    public void setBrand(String brand) {
        this.brand = brand;
    }

    public int getMaxSpeed() {
        return maxSpeed;
    }

    public void setMaxSpeed(int maxSpeed) {
        this.maxSpeed = maxSpeed;
    }

    @Override
    public String toString() {
        return "Car [brand=" + brand + ", maxSpeed=" + maxSpeed + "]";
    }
}

class CloneTest {
    public static void main(String[] args) {
        try {
            Person p1 = new Person("dujubin", 33, new Car("Benz", 300));
            Person p2 = MyUtil.clone(p1); // 深度克隆
            p2.getCar().setBrand("BYD");
            // 修改克隆的 Person 对象 p2 关联的汽车对象的品牌属性
            // 原来的 Person 对象 p1 关联的汽车不会受到任何影响
            // 因为在克隆 Person 对象时其关联的汽车对象也被克隆了
            System.out.println(p1);
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
注意:基于序列化和反序列化实现的克隆不仅仅是深度克隆,更重要的是通过泛型限定,可以检查出要克隆的对象是否支持序列化,这项检查是编译器完成的,不是在运行时抛出异常,这种是方案明显优于使用 Object 类的 clone 方法克隆对象。让问题在编译的时候暴露出来总是好过把问题留到运行时。
序列化就是一种用来处理对象流的机制,所谓对象流也就是将对象的内容进行流化。可以对流化后的对象进行读写操作,也可将流化后的对象传输于网络之间。序列化是为了解决在对对象流进行读写操作时所引发的问题。序 列 化 的 实 现 : 将 需 要 被 序 列 化 的 类 实 现 Serializable 接 口 , 该 接 口 没 有 需 要 实 现 的 方 法 , implements Serializable 只是为了标注该对象是可被序列化的,然后使用一个输出流(如:FileOutputStream)来构造一个 ObjectOutputStream(对象流)对象,接着,使用 ObjectOutputStream 对象的 writeObject(Object obj)方法就可以将参数为 obj 的对象写出(即保存其状态),要恢复的话则用输入流。
我们都知道unix世界里、一切皆文件、而文件是什么呢?文件就是一串二进制流而已、不管socket、还是FIFO、管道、终端、对我们来说、一切都是文件、一切都是流、在信息交换的过程中、我们都是对这些流进行数据的收发操作、简称为I/O操作(input and output)、往流中读出数据、系统调用read、写入数据、系统调用write、不过话说回来了、计算机里有这么多的流、我怎么知道要操作哪个流呢?做到这个的就是文件描述符、即通常所说的fd、一个fd就是一个整数、所以对这个整数的操作、就是对这个文件(流)的操作、我们创建一个socket、通过系统调用会返回一个文件描述符、那么剩下对socket的操作就会转化为对这个描述符的操作、不能不说这又是一种分层和抽象的思想。
通常用户进程中的一个完整IO分为两个阶段:
设备空间<-------------> 内核空间、
内核空间<------------->用户空间、

对于一个输入操作来说、进程IO系统调用后、内核会先看缓冲区中有没有相应的缓存数据、没有的话再到设备中读取、因为设备IO一般速度较慢、需要等待、内核缓冲区有数据则直接复制到进程空间
分为两个步骤:1、数据准备。2、数据拷贝,同步模型通过recvfrom操作进行数据拷贝,必须等待数据拷贝完成
阻塞 I/O 是最简单的 I/O 模型,一般表现为进程或线程等待某个条件,如果条件不满足,则一直等下去。条件满足,则进行下一步操作。

应用进程通过系统调用 recvfrom 接收数据,但由于内核还未准备好数据报,应用进程就会阻塞住,直到内核准备好数据报,recvfrom 完成数据报复制工作,应用进程才能结束阻塞状态。
应用进程与内核交互,目的未达到之前,不再一味的等着,而是直接返回。然后通过轮询的方式,不停的去问内核数据准备有没有准备好。如果某一次轮询发现数据已经准备好了,那就把数据拷贝到用户空间中。

应用进程通过 recvfrom 调用不停的去和内核交互,直到内核准备好数据。如果没有准备好,内核会返回error,应用进程在得到error后,过一段时间再发送recvfrom请求。在两次发送请求的时间段,进程可以先做别的事情。
应用进程在读取文件时通知内核,如果某个 socket 的某个事件发生时,请向我发一个信号。在收到信号后,信号对应的处理函数会进行后续处理。

应用进程预先向内核注册一个信号处理函数,然后用户进程返回,并且不阻塞,当内核数据准备就绪时会发送一个信号给进程,用户进程便在信号处理函数中开始把数据拷贝的用户空间中。
多个进程的IO可以注册到同一个管道上,这个管道会统一和内核进行交互。当管道中的某一个请求需要的数据准备好之后,进程再把对应的数据拷贝到用户空间中。

IO多路转接是多了一个select函数,多个进程的IO可以注册到同一个select上,当用户进程调用该select,select会监听所有注册好的IO,如果所有被监听的IO需要的数据都没有准备好时,select调用进程会阻塞。当任意一个IO所需的数据准备好之后,select调用就会返回,然后进程在通过recvfrom来进行数据拷贝。
**这里的IO复用模型,并没有向内核注册信号处理函数,所以,他并不是非阻塞的。**进程在发出select后,要等到select监听的所有IO操作中至少有一个需要的数据准备好,才会有返回,并且也需要再次发送请求去进行文件的拷贝。
应用进程把IO请求传给内核后,完全由内核去操作文件拷贝。内核完成相关操作后,会发信号告诉应用进程本次IO已经完成。

用户进程发起aio_read操作之后,给内核传递描述符、缓冲区指针、缓冲区大小等,告诉内核当整个操作完成时,如何通知进程,然后就立刻去做其他事情了。当内核收到aio_read后,会立刻返回,然后内核开始等待数据准备,数据准备好以后,直接把数据拷贝到用户控件,然后再通知进程本次IO已经完成。

select, poll, epoll 都是I/O 多路复用模型。其中 select, poll 是 POSIX 规定的,而 epoll 是 Linux 专门有的特性,在 Linux 2.6 后加入的。select 和 poll 都是采用轮询的方式检查fd,而 epoll 使用事件的就绪通知方式。
进程可以通过 select、poll、epoll 发起 I/O 多路复用的系统调用,这些系统调用都是同步阻塞的:如果传入的多个文件描述符中,有描述符就绪,则返回就绪的描述符;否则如果所有文件描述符都未就绪,就阻塞调用进程,直到某个描述符就绪,或者阻塞时长超过设置的 timeout 后,再返回。
如果
timeout参数设为 NULL,会无限阻塞直到某个描述符就绪;如果timeout参数设为 0,会立即返回,不阻塞。
使用非阻塞 I/O 检查每个描述符的就绪状态。
I/O 多路复用内部会遍历集合中的每个文件描述符,判断其是否就绪:
for fd in read_set
    if( readable(fd) ) // 判断 fd 是否就绪
        count++
        FDSET(fd, &res_rset) // 将 fd 添加到就绪集合中
        break
...
return count
这里的 readable(fd) 就是一个非阻塞 I/O 调用。试想,如果这里使用阻塞 I/O,那么 fd 未就绪时,select 会阻塞在这个文件描述符上,无法检查下个文件描述符。
文件描述符(file descriptor)是一个非负整数,从 0 开始。进程使用文件描述符来标识一个打开的文件。
系统为每一个进程维护了一个文件描述符表,表示该进程打开文件的记录表,而文件描述符实际上就是这张表的索引。当进程打开(open)或者新建(create)文件时,内核会在该进程的文件列表中新增一个表项,同时返回一个文件描述符 —— 也就是新增表项的下标。
一般来说,每个进程最多可以打开 64 个文件,fd ∈ 0~63。在不同系统上,最多允许打开的文件个数不同,Linux 2.4.22 强制规定最多不能超过 1,048,576。
socket 是 Unix 中的术语。socket 可以用于同一台主机的不同进程间的通信,也可以用于不同主机间的通信。一个 socket 包含地址、类型和通信协议等信息,通过 socket() 函数创建:
int socket(int domain, int type, int protocol)
返回的就是这个 socket 对应的文件描述符 fd。
可以这样理解:socket 是进程间通信规则的高层抽象,而 fd 提供的是底层的具体实现。socket 与 fd 是一一对应的。通过 socket 通信,实际上就是通过文件描述符 fd 读写文件。这也符合 Unix“一切皆文件”的哲学。
后面可以将 socket 和 fd 视为同义词。
int select(int nfds,
            fd_set *restrict readfds,
            fd_set *restrict writefds,
            fd_set *restrict errorfds,
struct timeval *restrict timeout);readfds、writefds、errorfds 是三个文件描述符集合。select 会遍历每个集合的前 nfds 个描述符,分别找到可以读取、可以写入、发生错误的描述符,统称为“就绪”的描述符。然后用找到的子集替换参数中的对应集合,返回所有就绪描述符的总数。
timeout 参数表示调用 select 时的阻塞时长。如果所有文件描述符都未就绪,就阻塞调用进程,直到某个描述符就绪,或者阻塞超过设置的 timeout 后,返回。如果 timeout 参数设为 NULL,会无限阻塞直到某个描述符就绪;如果 timeout 参数设为 0,会立即返回,不阻塞。
函数返回值int表示: 就绪描述符的数量,如果为-1表示产生错误 。
参数中的 fd_set 类型表示文件描述符的集合。
由于文件描述符 fd 是一个从 0 开始的无符号整数,所以可以使用 fd_set 的二进制每一位来表示一个文件描述符。某一位为 1,表示对应的文件描述符已就绪。比如比如设 fd_set 长度为 1 字节,则一个 fd_set 变量最大可以表示 8 个文件描述符。当 select 返回 fd_set = 00010011 时,表示文件描述符 1、2、5 已经就绪。
fd_set 的使用涉及以下几个 API:
#include <sys/select.h>
int FD_ZERO(int fd, fd_set *fdset);  // 将 fd_set 所有位置 0
int FD_CLR(int fd, fd_set *fdset);   // 将 fd_set 某一位置 0
int FD_SET(int fd, fd_set *fd_set);  // 将 fd_set 某一位置 1
int FD_ISSET(int fd, fd_set *fdset); // 检测 fd_set 某一位是否为 1Select会将全量fd_set从用户空间拷贝到内核空间,并注册回调函数, 在内核态空间来判断每个请求是否准备好数据 。select在没有查询到有文件描述符就绪的情况下,将一直阻塞(I/O多路复用中提过:select是一个阻塞函数)。如果有一个或者多个描述符就绪,那么select将就绪的文件描述符置位,通过select返回。返回后,由程序遍历查看哪个请求有数据。
- 先声明一个
fd_set类型的变量readFDs - 调用
FD_ZERO,将readFDs所有位置 0 - 调用
FD_SET,将readFDs感兴趣的位置 1,表示要监听这几个文件描述符 - 将
readFDs传给select,调用select select会将readFDs中就绪的位置 1,未就绪的位置 0,返回就绪的文件描述符的数量- 当
select返回后,调用FD_ISSET检测给定位是否为 1,表示对应文件描述符是否就绪
比如进程想监听 1、2、5 这三个文件描述符,就将 readFDs 设置为 00010011,然后调用 select。
如果 fd=1、fd=2 就绪,而 fd=5 未就绪,select 会将 readFDs 设置为 00000011 并返回 2。
如果每个文件描述符都未就绪,select 会阻塞 timeout 时长,再返回。这期间,如果 readFDs 监听的某个文件描述符上发生可读事件,则 select 会将对应位置 1,并立即返回。
- 性能开销大
- 调用
select时会陷入内核,这时需要将参数中的fd_set从用户空间拷贝到内核空间 - 内核需要遍历传递进来的所有
fd_set的每一位,不管它们是否就绪
- 调用
- 同时能够监听的文件描述符数量太少。受限于
sizeof(fd_set)的大小,在编译内核时就确定了且无法更改。一般是 1024,不同的操作系统不相同
poll 和 select 几乎没有区别。poll 采用链表的方式存储文件描述符,没有最大存储数量的限制(Poll机制突破了Select机制中的文件描述符数量最大为1024的限制)。
从性能开销上看,poll 和 select 的差别不大。
int poll(struct pollfd fds[], nfds_t nfds, int timeout);
Return number of ready file descriptors, 0 on timeout, -1 on error.其中参数fds是一个链表,pollfd的结构定义为:
struct pollfd {
    int    fd;        /* File descriptor */
    short  events;    /* Requested events bit mask */
    short  revents;   /* Returned events bit mast */
}
结构体中fd为需要监听的文件描述符,events为需要监听的事件类型,而revents为经过poll调用之后返回的事件类型,在调用poll的时候,一般会传入一个pollfd的结构体数组,数组的元素个数表示监控的描述符个数。
可以看到,不同于 select,poll 里每个fd只需要在链表里存在一个就够了。
- select 参数使用的类型是
fd_set,而 poll 使用的是链表。前者由上限值而后者没有。 - 在循环调用中,由于 select 的参数
fd_set是参数同时也是保存结果的地方,所以每次调用前都需要重新初始化参数,而 poll 则不需要。 - select 使用的
timeout为微秒,而 poll 为毫秒。 - 如果其中一个
fd关闭了,poll 可以通过revents字段设定POLLNVAL标记,而 select 会返回 -1。
Poll机制相较于Select机制中,解决了文件描述符数量上限为1024的缺陷。但另外两点缺陷依然存在:
- 每次调用poll,都需要把fd集合从用户态拷贝到内核态,fd越多开销则越大;
- 每次调用poll,都需要在内核遍历传递进来的所有fd,这个开销在fd很多时也很大
epoll 是对 select 和 poll 的改进,避免了“性能开销大”和“文件描述符数量少”两个缺点。
简而言之,epoll 有以下几个特点:
- 使用红黑树存储文件描述符集合
- 使用队列存储就绪的文件描述符
- 每个文件描述符只需在添加时传入一次;通过事件更改文件描述符状态
select、poll 模型都只使用一个函数,而 epoll 模型使用三个函数:epoll_create、epoll_ctl 和 epoll_wait。
int epoll_create(int size);epoll_create 会创建一个 epoll 实例,同时返回一个引用该实例的文件描述符。
返回的文件描述符仅仅指向对应的 epoll 实例,并不表示真实的磁盘文件节点。其他 API 如 epoll_ctl、epoll_wait 会使用这个文件描述符来操作相应的 epoll 实例。
当创建好 epoll 句柄后,它会占用一个 fd 值,在 linux 下查看 /proc/进程id/fd/,就能够看到这个 fd。所以在使用完 epoll 后,必须调用 close(epfd) 关闭对应的文件描述符,否则可能导致 fd 被耗尽。当指向同一个 epoll 实例的所有文件描述符都被关闭后,操作系统会销毁这个 epoll 实例。
epoll 实例内部存储:
- 监听列表:所有要监听的文件描述符,使用红黑树
- 就绪列表:所有就绪的文件描述符,使用链表
int epoll_ctl(int epfd, int op, int fd, struct epoll_event *event);
epoll_ctl 会监听文件描述符 fd 上发生的 event 事件(向epoll中注册事件,该函数如果调用成功返回0,否则返回-1)。
参数说明:
epfd即epoll_create返回的文件描述符,指向一个epoll实例fd表示要监听的目标文件描述符event表示要监听的事件(可读、可写、发送错误…)op表示要对fd执行的操作,有以下几种:EPOLL_CTL_ADD:为fd添加一个监听事件eventEPOLL_CTL_MOD:Change the event event associated with the target file descriptor fd(event是一个结构体变量,这相当于变量event本身没变,但是更改了其内部字段的值)EPOLL_CTL_DEL:删除fd的所有监听事件,这种情况下event参数没用
返回值 0 或 -1,表示上述操作成功与否。
epoll_ctl 会将文件描述符 fd 添加到 epoll 实例的监听列表里,同时为 fd 设置一个回调函数,并监听事件 event。当 fd 上发生相应事件时,会调用回调函数,将 fd 添加到 epoll 实例的就绪队列上。
int epoll_wait(int epfd, struct epoll_event *events,int maxevents, int timeout);这是 epoll 模型的主要函数,类似与select机制中的select函数、poll机制中的poll函数,等待内核返回监听描述符的事件产生。该函数返回已经就绪的事件的数量,如果为-1表示出错。
参数说明:
epfd即epoll_create返回的文件描述符,指向一个epoll实例events是一个数组,保存就绪状态的文件描述符,其空间由调用者负责申请maxevents指定events的大小timeout类似于select中的 timeout。如果没有文件描述符就绪,即就绪队列为空,则epoll_wait会阻塞 timeout 毫秒。如果 timeout 设为 -1,则epoll_wait会一直阻塞,直到有文件描述符就绪;如果 timeout 设为 0,则epoll_wait会立即返回
返回值表示 events 中存储的就绪描述符个数,最大不超过 maxevents。
epoll 是对 select 和 poll 的改进,避免了“性能开销大”和“文件描述符数量少”两个缺点。
对于“文件描述符数量少”,select 使用整型数组存储文件描述符集合,而 epoll 使用红黑树存储,数量较大。
对于“性能开销大”,epoll_ctl 中为每个文件描述符指定了回调函数,并在就绪时将其加入到就绪列表,因此 epoll 不需要像 select 那样遍历检测每个文件描述符,只需要判断就绪列表是否为空即可。这样,在没有描述符就绪时,epoll 能更早地让出系统资源。
相当于时间复杂度从 O(n) 降为 O(1)
此外,每次调用 select 时都需要向内核拷贝所有要监听的描述符集合,而 epoll 对于每个描述符,只需要在 epoll_ctl 传递一次,之后 epoll_wait 不需要再次传递。这也大大提高了效率。
select 只支持水平触发,epoll 支持水平触发和边缘触发。
水平触发(LT,Level Trigger):当文件描述符就绪时,会触发通知,如果用户程序没有一次性把数据读/写完,下次还会发出可读/可写信号进行通知。
边缘触发(ET,Edge Trigger):仅当描述符从未就绪变为就绪时,通知一次,之后不会再通知。
区别:边缘触发效率更高,减少了事件被重复触发的次数,函数不会返回大量用户程序可能不需要的文件描述符。
水平触发、边缘触发的名称来源:数字电路当中的电位水平,高低电平切换瞬间的触发动作叫边缘触发,而处于高电平的触发动作叫做水平触发。
相较于Select和Poll,Epoll内部还分为两种工作模式: LT水平触发(level trigger)和ET边缘触发(edge trigger)。
- LT模式: 默认的工作模式,即当epoll_wait检测到某描述符事件就绪并通知应用程序时,应用程序可以不立即处理该事件;事件会被放回到就绪链表中,下次调用epoll_wait时,会再次通知此事件。
- ET模式: 当epoll_wait检测到某描述符事件就绪并通知应用程序时,应用程序必须立即处理该事件。如果不处理,下次调用epoll_wait时,不会再次响应并通知此事件。
由于上述两种工作模式的区别,LT模式同时支持block和no-block socket两种,而ET模式下仅支持no-block socket。即epoll工作在ET模式的时候,必须使用非阻塞套接口,以避免由于一个fd的阻塞I/O操作把多个处理其他文件描述符的任务饿死。ET模式在很大程度上减少了epoll事件被重复触发的次数,因此效率要比LT模式高。
- 每次通过
read系统调用读取数据时,最多只能读取缓冲区大小的字节数;如果某个文件描述符一次性收到的数据超过了缓冲区的大小,那么需要对其read多次才能全部读取完毕 select可以使用阻塞 I/O。通过 select获取到所有可读的文件描述符后,遍历每个文件描述符,read一次数据- 这些文件描述符都是可读的,因此即使
read是阻塞 I/O,也一定可以读到数据,不会一直阻塞下去 select采用水平触发模式,因此如果第一次read没有读取完全部数据,那么下次调用select时依然会返回这个文件描述符,可以再次readselect也可以使用非阻塞 I/O。当遍历某个可读文件描述符时,使用for循环调用read多次,直到读取完所有数据为止(返回EWOULDBLOCK)。这样做会多一次read调用,但可以减少调用select的次数
- 这些文件描述符都是可读的,因此即使
- 在
epoll的边缘触发模式下,只会在文件描述符的可读/可写状态发生切换时,才会收到操作系统的通知- 因此,如果使用
epoll的边缘触发模式,在收到通知时,必须使用非阻塞 I/O,并且必须循环调用read或write多次,直到返回EWOULDBLOCK为止,然后再调用epoll_wait等待操作系统的下一次通知 - 如果没有一次性读/写完所有数据,那么在操作系统看来这个文件描述符的状态没有发生改变,将不会再发起通知,调用
epoll_wait会使得该文件描述符一直等待下去,服务端也会一直等待客户端的响应,业务流程无法走完 - 这样做的好处是每次调用
epoll_wait都是有效的——保证数据全部读写完毕了,等待下次通知。在水平触发模式下,如果调用epoll_wait时数据没有读/写完毕,会直接返回,再次通知。因此边缘触发能显著减少事件被触发的次数 - 为什么
epoll的边缘触发模式不能使用阻塞 I/O?很显然,边缘触发模式需要循环读/写一个文件描述符的所有数据。如果使用阻塞 I/O,那么一定会在最后一次调用(没有数据可读/写)时阻塞,导致无法正常结束
- 因此,如果使用
select:调用开销大(需要复制集合);集合大小有限制;需要遍历整个集合找到就绪的描述符poll:poll 采用链表的方式存储文件描述符,没有最大存储数量的限制,其他方面和 select 没有区别epoll:调用开销小(不需要复制);集合大小无限制;采用回调机制,不需要遍历整个集合
select、poll 都是在用户态维护文件描述符集合,因此每次需要将完整集合传给内核;epoll 由操作系统在内核中维护文件描述符集合,因此只需要在创建的时候传入文件描述符。
此外 select 只支持水平触发,epoll 支持边缘触发。

当连接数较多并且有很多的不活跃连接时,epoll 的效率比其它两者高很多。当连接数较少并且都十分活跃的情况下,由于 epoll 需要很多回调,因此性能可能低于其它两者。
**Java中提供的IO有关的API,在文件处理的时候,其实依赖操作系统层面的IO操作实现的。**比如在Linux 2.6以后,Java中NIO和AIO都是通过epoll来实现的,而在Windows上,AIO是通过IOCP来实现的。
可以把Java中的BIO、NIO和AIO理解为是Java语言对操作系统的各种IO模型的封装。程序员在使用这些API的时候,不需要关心操作系统层面的知识,也不需要根据不同操作系统编写不同的代码。只需要使用Java的API就可以了。
Java BIO:同步并阻塞(传统阻塞型),服务器实现模式为一个连接一个线程,即客户端有连接请求时服务器端就需要启动一个线程进行处理,如果这个连接不作任何事情会造成不必要的线程开销。

Java NIO:同步非阻塞,服务器实现模式为一个线程处理多个请求(连接),即客户端发送的连接请求会被注册到多路复用器上,多路复用器轮询到有 I/O 请求就会进行处理。

Java AIO:异步非阻塞,AIO 引入了异步通道的概念,采用了 Proactor 模式,简化了程序编写,有效的请求才启动线程,它的特点是先由操作系统完成后才通知服务端程序启动线程去处理,一般适用于连接数较多且连接时间较长的应用。
同步阻塞:你到饭馆点餐,然后在那等着,还要一边喊:好了没啊!同步非阻塞:在饭馆点完餐,就去遛狗了。不过溜一会儿,就回饭馆喊一声:好了没啊!异步阻塞:遛狗的时候,接到饭馆电话,说饭做好了,让您亲自去拿。异步非阻塞:饭馆打电话说,我们知道您的位置,一会给你送过来,安心遛狗就可以了。
- BIO 方式适用于
连接数比较小且固定的架构,这种方式对服务器资源要求比较高,并发局限于应用中,JDK1.4 之前唯一的选择,程序较为简单容易理解。 - NIO 方式适用于
连接数目多且连接比较短的架构,比如聊天服务器,弹幕系统,服务器间通讯等,编程比较复杂,JDK1.4 开始支持。 - AIO 方式适用于
连接数目多且连接比较长的架构,比如相册服务器,充分调用 OS 参与并发操作,变成比较复杂,JDK7 开始支持。
- Java BIO 就是传统的 Java IO 编程,其相关的类和接口在 java.io 包下。
- BIO(Blocking I/O):
同步阻塞,服务器实现模式为一个连接一个线程,即客户端有连接请求时,服务器就会需要启动一个线程来进行处理。如果这个连接不作任何事情就会造成不必要的开销,可以通过线程池机制改善。
- 每个请求都需要创建独立的线程,与对应的客户端进行数据处理。
- 当并发数大时,需要
创建大量线程来处理连接,系统资源占用较大。 - 连接建立后,如果当前线程暂时没有数据可读,则当前线程会一直阻塞在 Read 操作上,造成线程资源浪费。
- Java NIO 全称 Java non-blocking IO,指的是 JDK 提供的新 API。从 JDK 1.4 开始,Java 提供了一系列改进的输入/输出的新特性,被统称为 NIO,即 New IO,是
同步非阻塞的。 - NIO 相关类都放在 java.nio 包下,并对原 java.io 包中很多类进行了改写。
- NIO 有三大核心部分:
Channel(管道)、Buffer(缓冲区)、Selector(选择器)。 - NIO 是面向
缓冲区编程的。数据读取到了一个它稍微处理的缓冲区,需要时可在缓冲区中前后移动,这就增加了处理过程中的灵活性,使用它可以提供非阻塞的高伸缩性网络。 - Java NIO 的非阻塞模式,使一个线程从某通道发送请求读取数据,但是它仅能得到目前可用数据,如果目前没有可用数据时,则说明都不会获取,而不是保持线程阻塞,所以直到数据变为可以读取之前,该线程可以做其他事情。非阻塞写入同理。
- BIO 以流的方式处理数据,而 NIO 以块的方式处理数据,块 I/O 的效率比流 I/O 高很多。
- BIO 是阻塞的,而 NIO 是非阻塞的。
- BIO 基于字节流和字符流进行操作,而 NIO 基于 Channel(通道)和 Buffer(缓冲区)进行操作,数据总是从通道读取到缓冲区中,或者从缓冲区写入到通道中。Selector(选择器)用于监听多个通道事件(比如连接请求,数据到达等),因此
使用单个线程就可以监听多个客户端通道。
- 每个 Channel 对应一个 Buffer。
- Selector 对应一个线程,一个线程对应多个 Channel。
- 该图反应了有三个 Channel 注册到该 Selector。
- 程序切换到那个 Channel 是由
事件决定的(Event)。 - Selector 会根据不同的事件,在各个通道上切换。
- Buffer 就是一个内存块,底层是有一个数组。
- 数据的读取和写入是通过 Buffer,但是需要
flip()切换读写模式。而 BIO 是单向的,要么输入流要么输出流。

- Java 的 NIO 使用了非阻塞的 I/O 方式。可以用一个线程处理若干个客户端连接,就会使用到 Selector(选择器)。
- Selector 能够检测到多个注册通道上是否有事件发生(多个 Channel 以事件的形式注册到同一个 selector),如果有事件发生,便获取事件然后针对每个事件进行相应的处理。
- 只有在连接真正有读写事件发生时,才会进行读写,减少了系统开销,并且不必为每个连接都创建一个线程,不用维护多个线程。
- 避免了多线程之间上下文切换导致的开销。
Netty 的 I/O 线程 NioEventLoop 聚合了 Selector(选择器 / 多路复用器),可以并发处理成百上千个客户端连接。
当线程从某客户端 Socket 通道进行读写时,若没有数据可用,该线程可以进行其他任务。
线程通常将非阻塞 I/O 的空闲时间用于其他通道上执行 I/O 操作,所以单独的线程可以管理多个输入输出通道。
由于读写操作都是非阻塞的,就可以充分提高 I/O 线程的运行效率,避免由于频繁 I/O 阻塞导致的线程挂起。
一个 I/O 线程可以并发处理 N 个客户端连接和读写操作,这从根本上解决了传统同步阻塞 I/O 一连接一线程模型,架构性能、弹性伸缩能力和可靠性都得到极大地提升。
JDK 7 引入了 Asynchronous I/O,即 AIO。在进行 I/O 编程中,通常用到两种模式:Reactor 和 Proactor 。Java 的 NIO 就是 Reactor,当有事件触发时,服务器端得到通知,进行相应的处理。
AIO 叫做异步非阻塞的 I/O,引入了异步通道的概念,采用了 Proactor 模式,简化了程序编写,有效的请求才会启动线程,特点就是先由操作系统完成后才通知服务端程序启动线程去处理,一般用于连接数较多且连接时长较长的应用。
Reactor 与 Proactor
- 两种 IO 多路复用方案:Reactor and Proactor。
- Reactor 模式是基于同步 I/O 的,而 Proactor 模式是和异步 I/O 相关的。